最常见的原因不是系统本身有问题,而是出入库、调拨、退货和盘点没有在同一条流程里实时更新。前台先卖货、仓库后补单,或者多仓之间靠 Excel 和群消息传递,都会让账面库存和实物越偏越大。更稳妥的做法是把扫码、入库校验、出库扣减和差异复盘接到统一流程里,让每一次库存变动都有记录可追。
查看对应文章进销存专题
哪个品该补货、哪个品该清仓?采购量按什么算才合理?出库优先级怎么排?本专题从这些具体问题切入,帮你系统梳理进销存管理的关键方法。
共 2594 篇文章 累计阅读 87.2k+ 最近更新 2026-11-14
相关最新文章
数据管理对仓库的作用揭秘 数据管理如何提升仓库效率?
高效的数据管理可以显著提升仓库效率与周转能力。通过规范的数据采集、统一的数据标准、实时库存监控和智能分析,仓库能够减少缺货与积压,缩短拣货时间,降低差错率。建立完善的数据管理体系后,仓库流程更可视、可控、可追溯,管理层可以依据数据决策补货策略、库位规划与人员调度。引入数字化系统(如云端WMS与进销存系统)能打通采购、仓储、销售、财务的数据链条,实现跨部门协同。对于成长中的企业,逐步用系统替代手工表格与纸质单据,是从“粗放仓库”走向“精细管理”的关键路径,为未来智能仓储、自动化物流打下基础。
数据仓库设计和管理要求详解,如何高效满足企业需求?
在企业级数据仓库项目中,要高效满足业务需求,需要在架构设计、数据建模、性能优化、数据质量管理、安全与合规以及运维治理上形成系统化方法。相比传统只关注“把数据存进去”,现代数据仓库更强调面向主题建模、可扩展的数据架构、清晰的元数据管理、统一的口径与高可用性。在实践中,消费级 BI 工具、云数仓、数据湖等技术的引入,让数据仓库设计更偏向“全链路治理”。从需求分析开始就考虑报表场景、指标口径、访问模式和权限边界,可以显著降低后期维护成本,避免反复重构。通过合理的数据分层、维度建模或 Data Vault、自动化 ETL/ELT 流程,再配合监控告警与数据血缘分析,才能真正做到数据仓库既稳又快,又能持续支撑企业不断变化的业务需求与数字化转型。
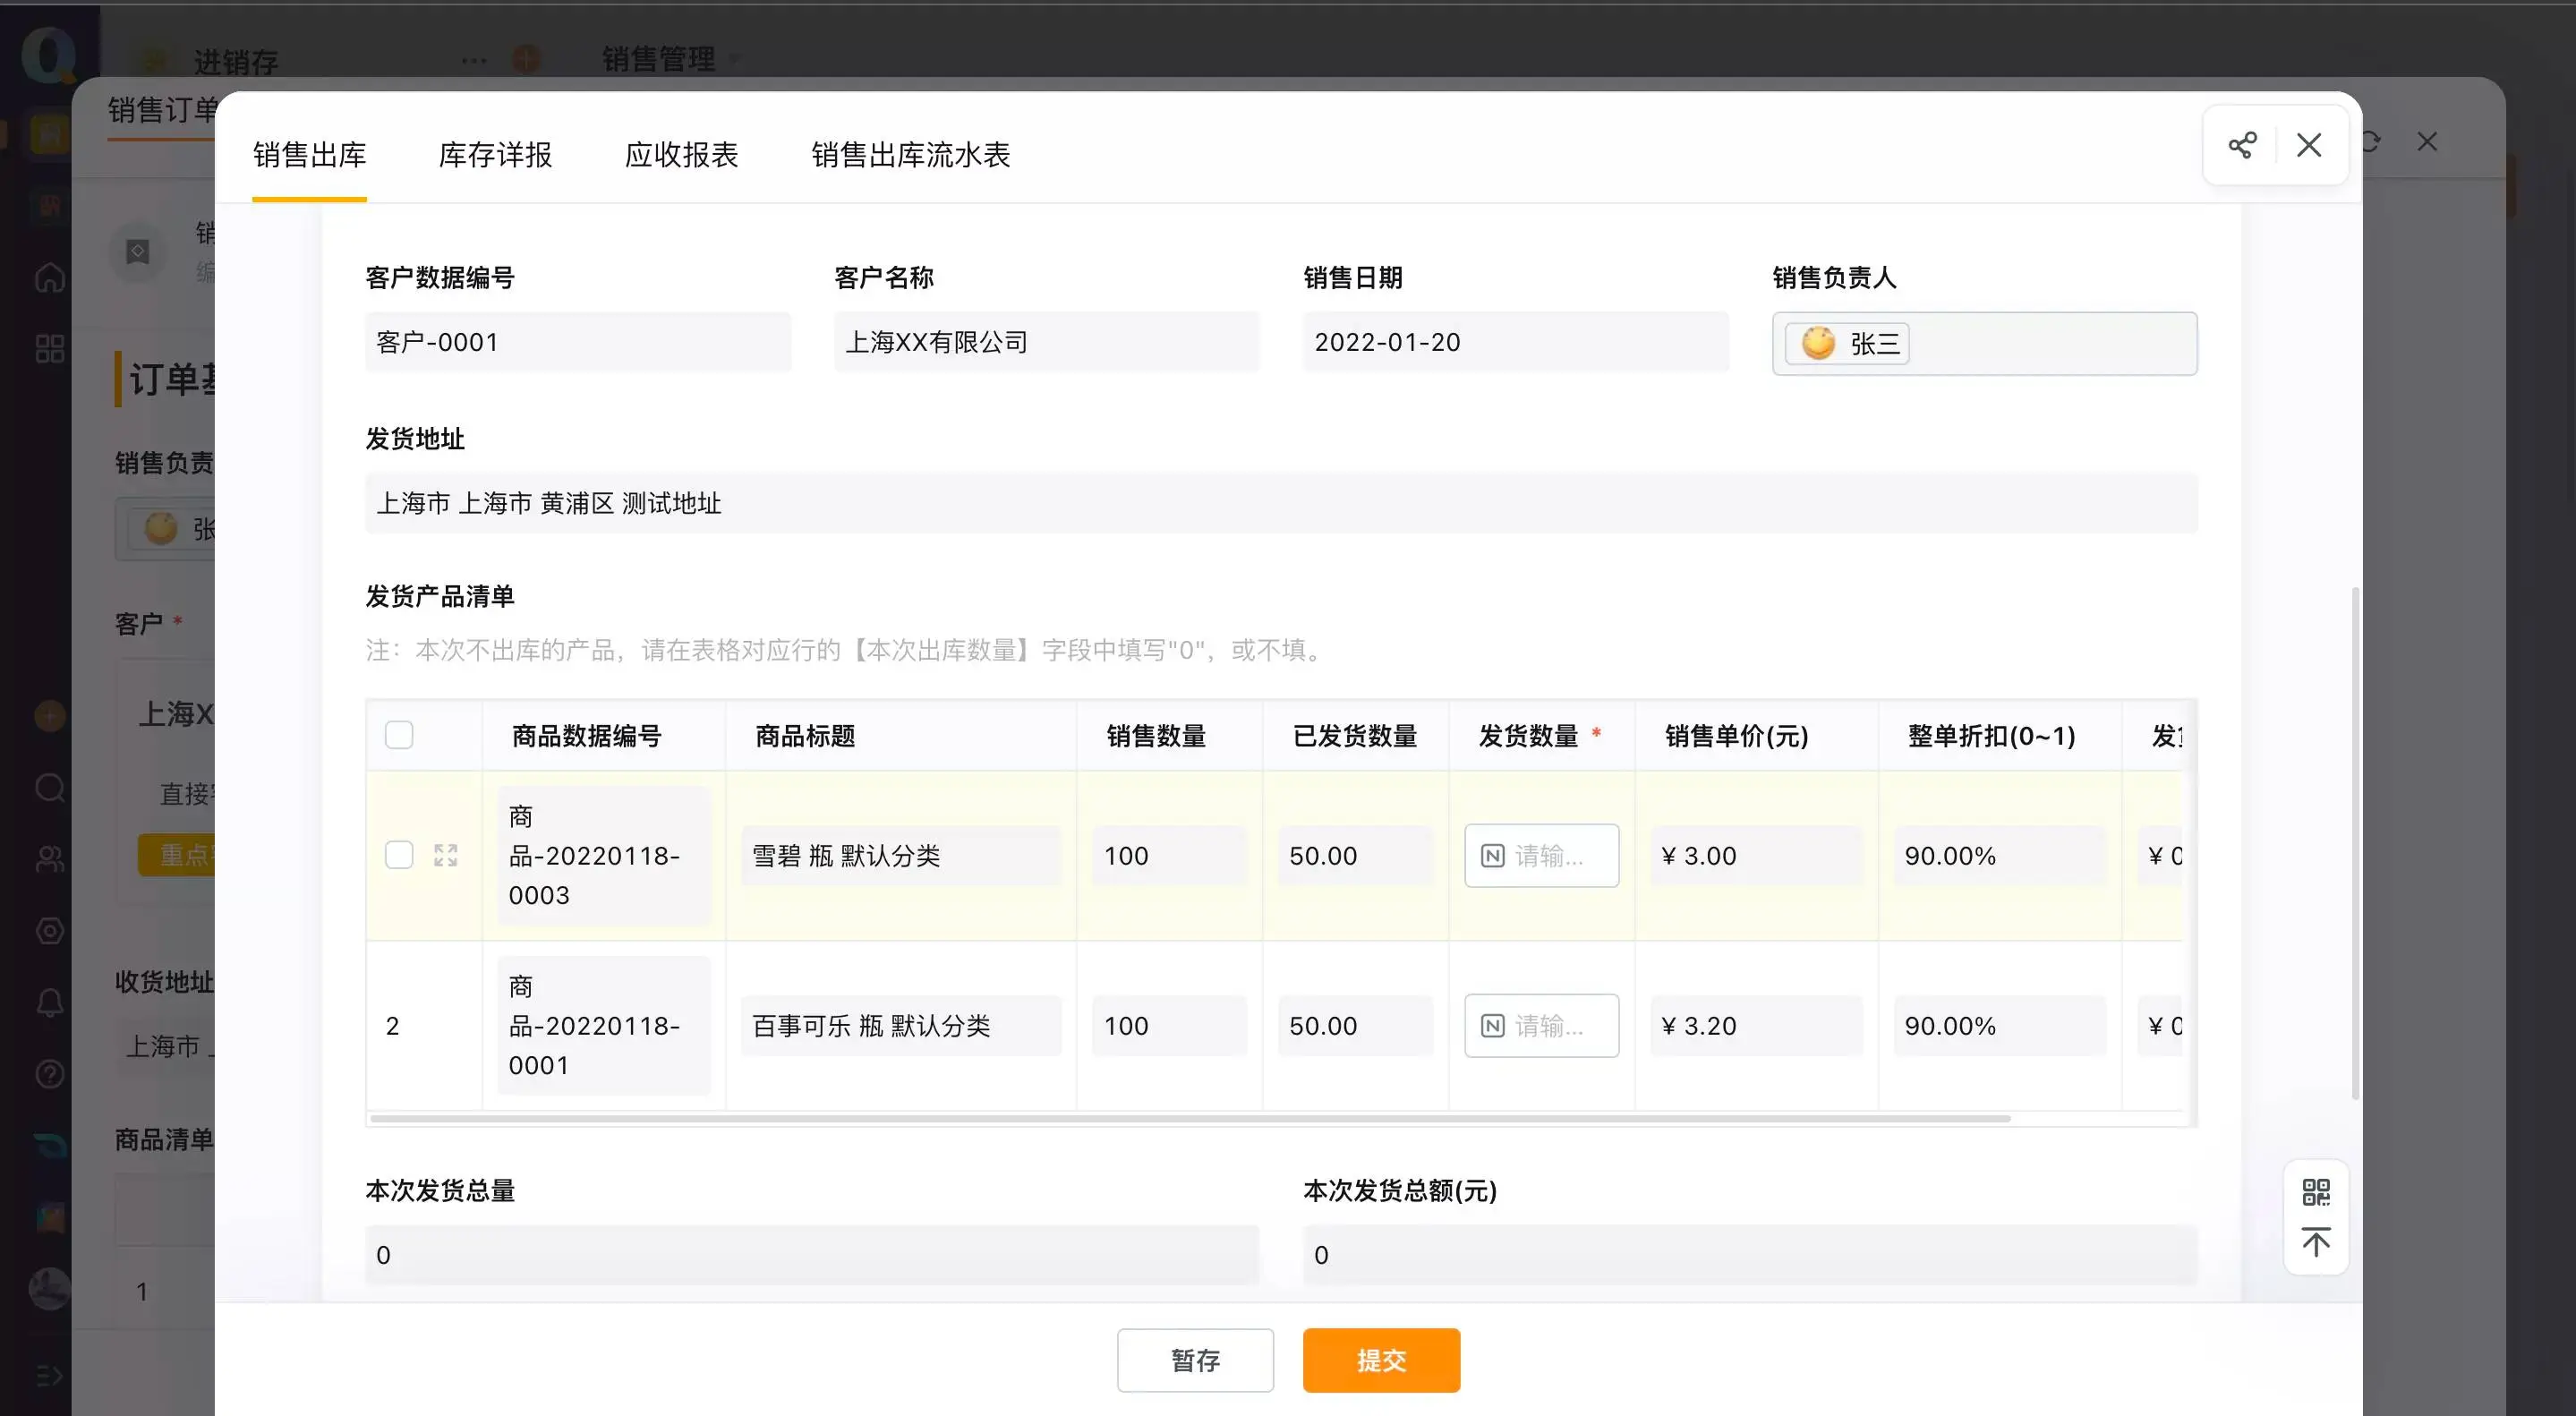
数据仓库模型在线管理最佳实践,如何提升效率?
数据仓库模型在线管理的效率提升,关键在于:统一模型资产、规范建模流程、自动化版本与发布、可视化协作,以及与开发/运维体系的深度集成。实现高效在线管理,需要基于统一元数据平台,将维度建模、事实建模、ETL 规则、血缘关系和质量规则集中管理;通过标准化命名规范、模型评审机制和模板化设计,减少重复劳动;利用在线建模、自动 DDL 生成、自动代码同步、自动化测试与部署,显著缩短迭代周期;并借助权限控制、变更审计、数据字典和协作评论机制,保证多人协作下的可控性与可追溯性。在实际落地中,选用支持云端协同、接口开放、可与 BI/ETL/运维工具打通的在线数据仓库模型管理平台,是提升整体效率和数据资产价值的关键抓手。
数据仓库管理系统推荐,哪个品牌更值得选择?
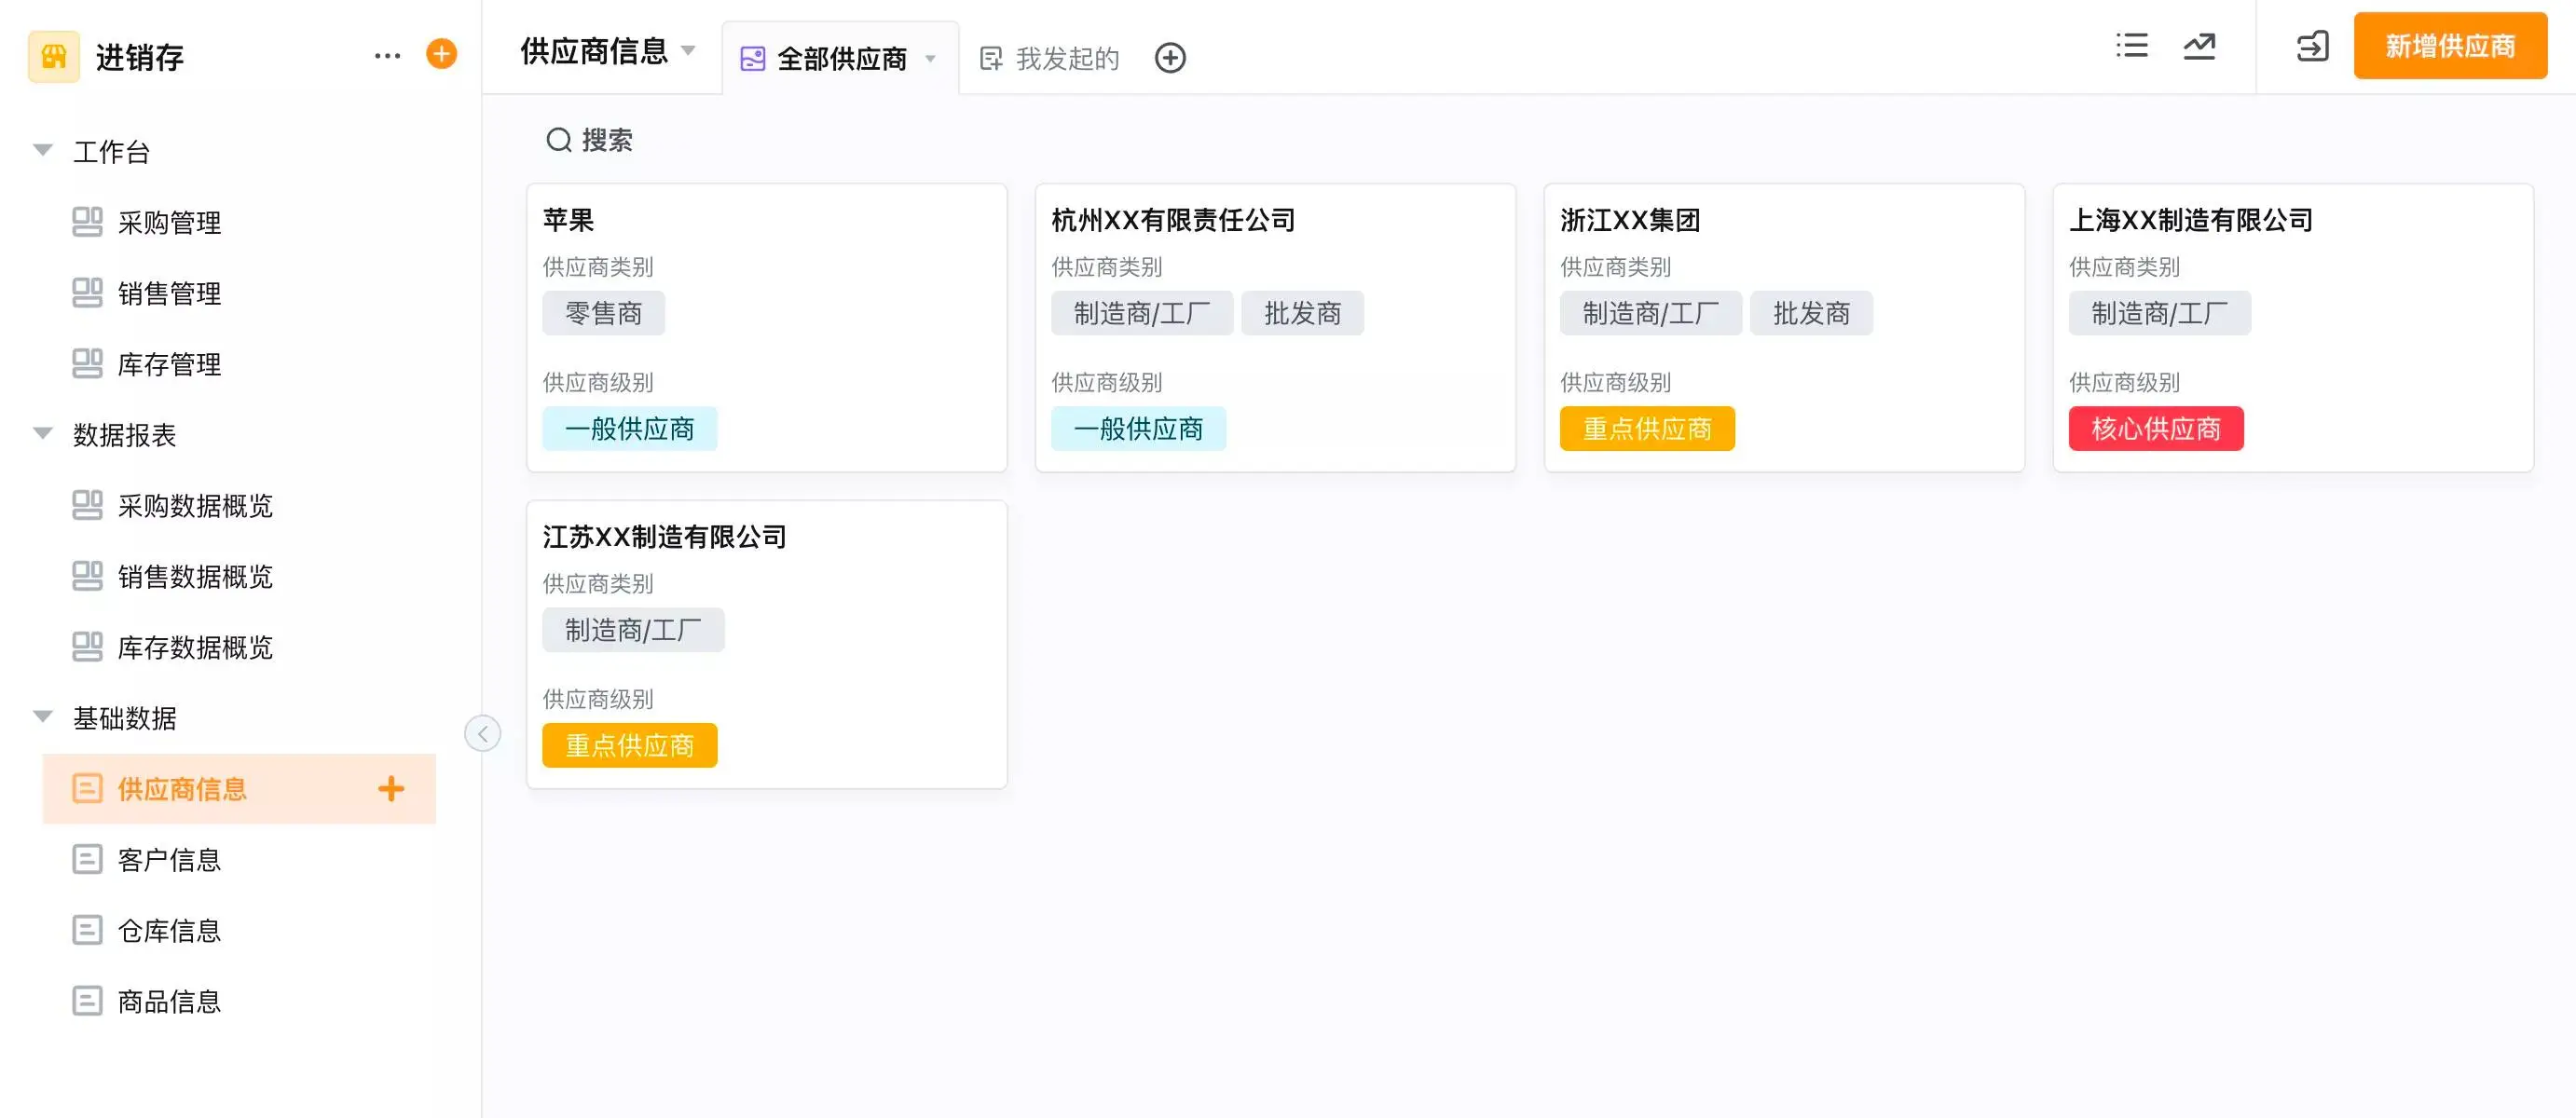
在选择数据仓库管理系统时,更值得关注的是架构成熟度、云平台生态、数据治理能力与成本结构,而不是单纯的品牌知名度。在当前主流品牌中,Snowflake、Amazon Redshift、Google BigQuery、Azure Synapse在公有云数据仓库领域表现突出;而 Oracle Exadata、Teradata、SAP BW/4HANA 等则在大型企业私有部署与混合场景中更具优势。对于中小团队或快速试错项目,使用云端托管型数据仓库管理系统或低代码工具,有助于在控制成本的同时加快交付。对于需要同时管理仓储业务与库存数据的企业,可在数据仓库之上配合使用如 轻流进销存 / WMS 仓库管理系统模板 等在线系统,以打通业务数据与分析数据闭环,从而提升整体供应链管理效率与决策质量。
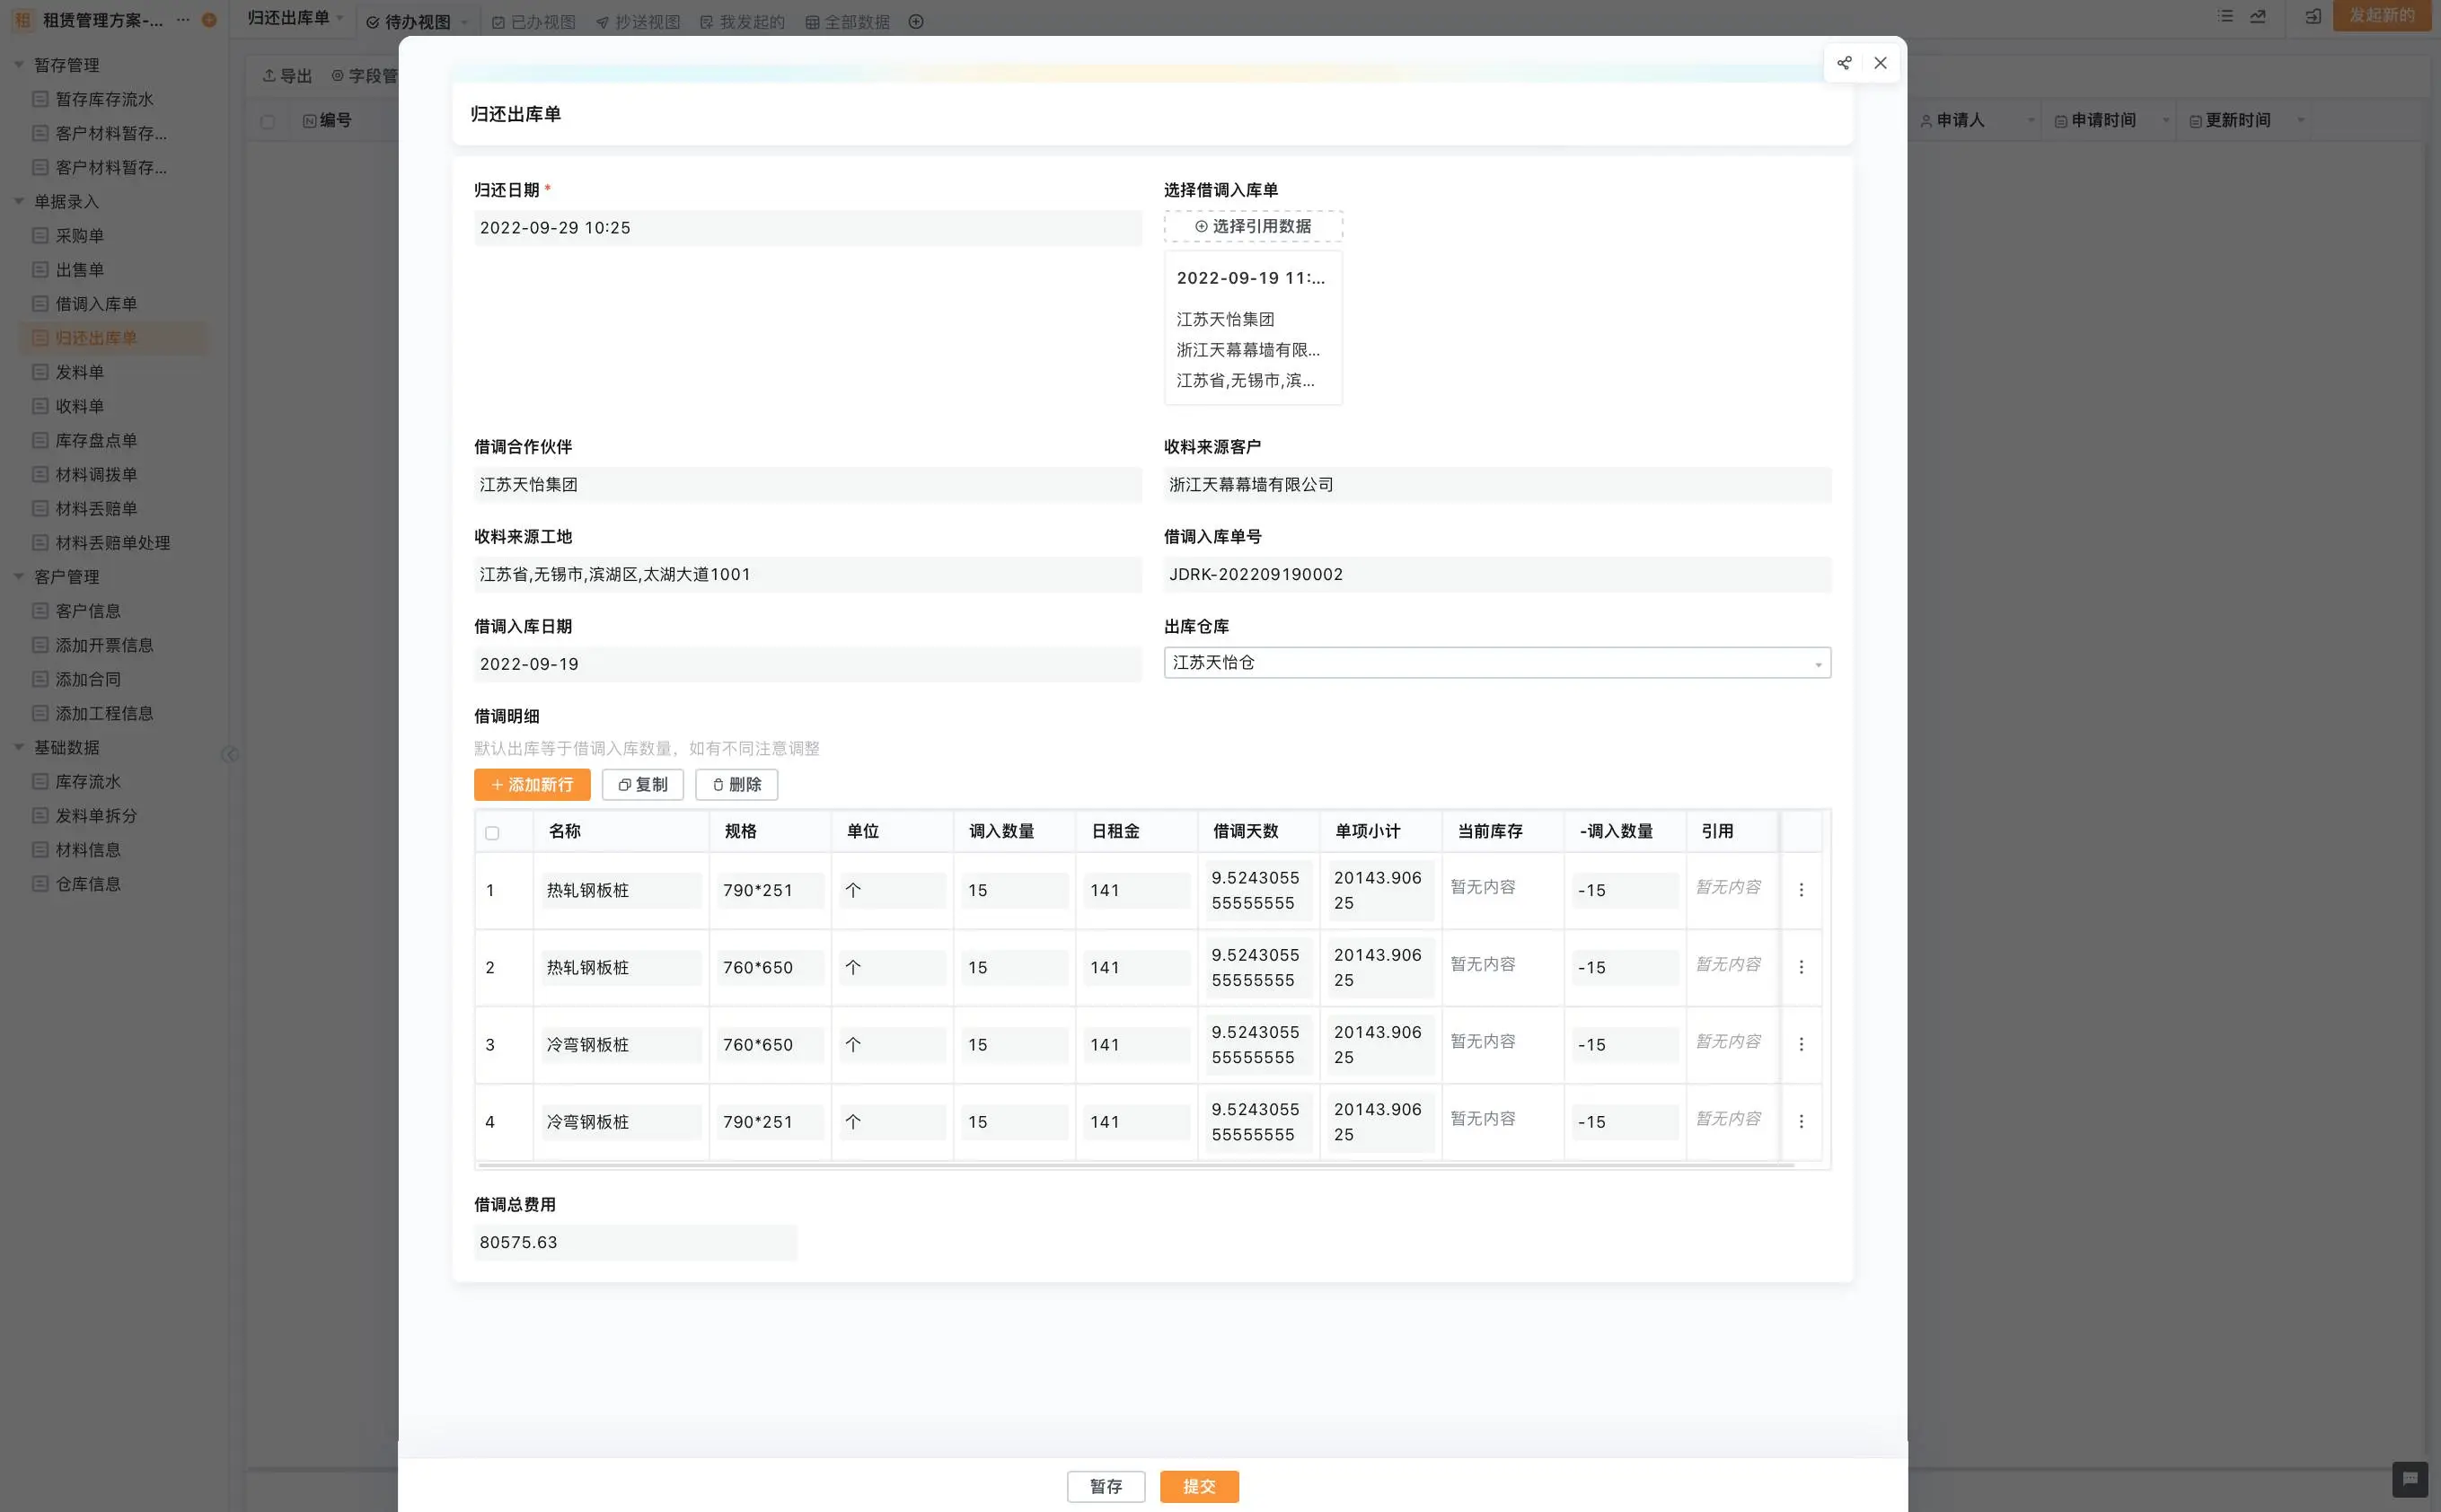
数据仓库管理体系架构解析,如何构建高效数据仓库?
构建高效的数据仓库,核心在于从一开始就设计清晰的管理体系架构,用规范的数据建模方法、稳定的ETL流程、灵活的存储与计算资源,以及统一的数据治理机制来支撑业务分析与决策。在合理的架构下,数据仓库能帮助企业整合多源业务数据、沉淀统一指标口径、提升数据质量与可用性,并有效支撑BI报表、管理驾驶舱和数据分析场景。相反,缺乏体系化规划的数据仓库,往往会被“烟囱式数据集市、口径混乱、数据冗余与性能瓶颈”拖垮。因此,在技术选型上要兼顾云原生平台与本地部署方案,在治理上要建立完善的元数据管理、权限管理与数据安全机制,在运营上通过标准化与自动化,形成持续优化的闭环,才能构建真正高效、可扩展的数据仓库管理体系。
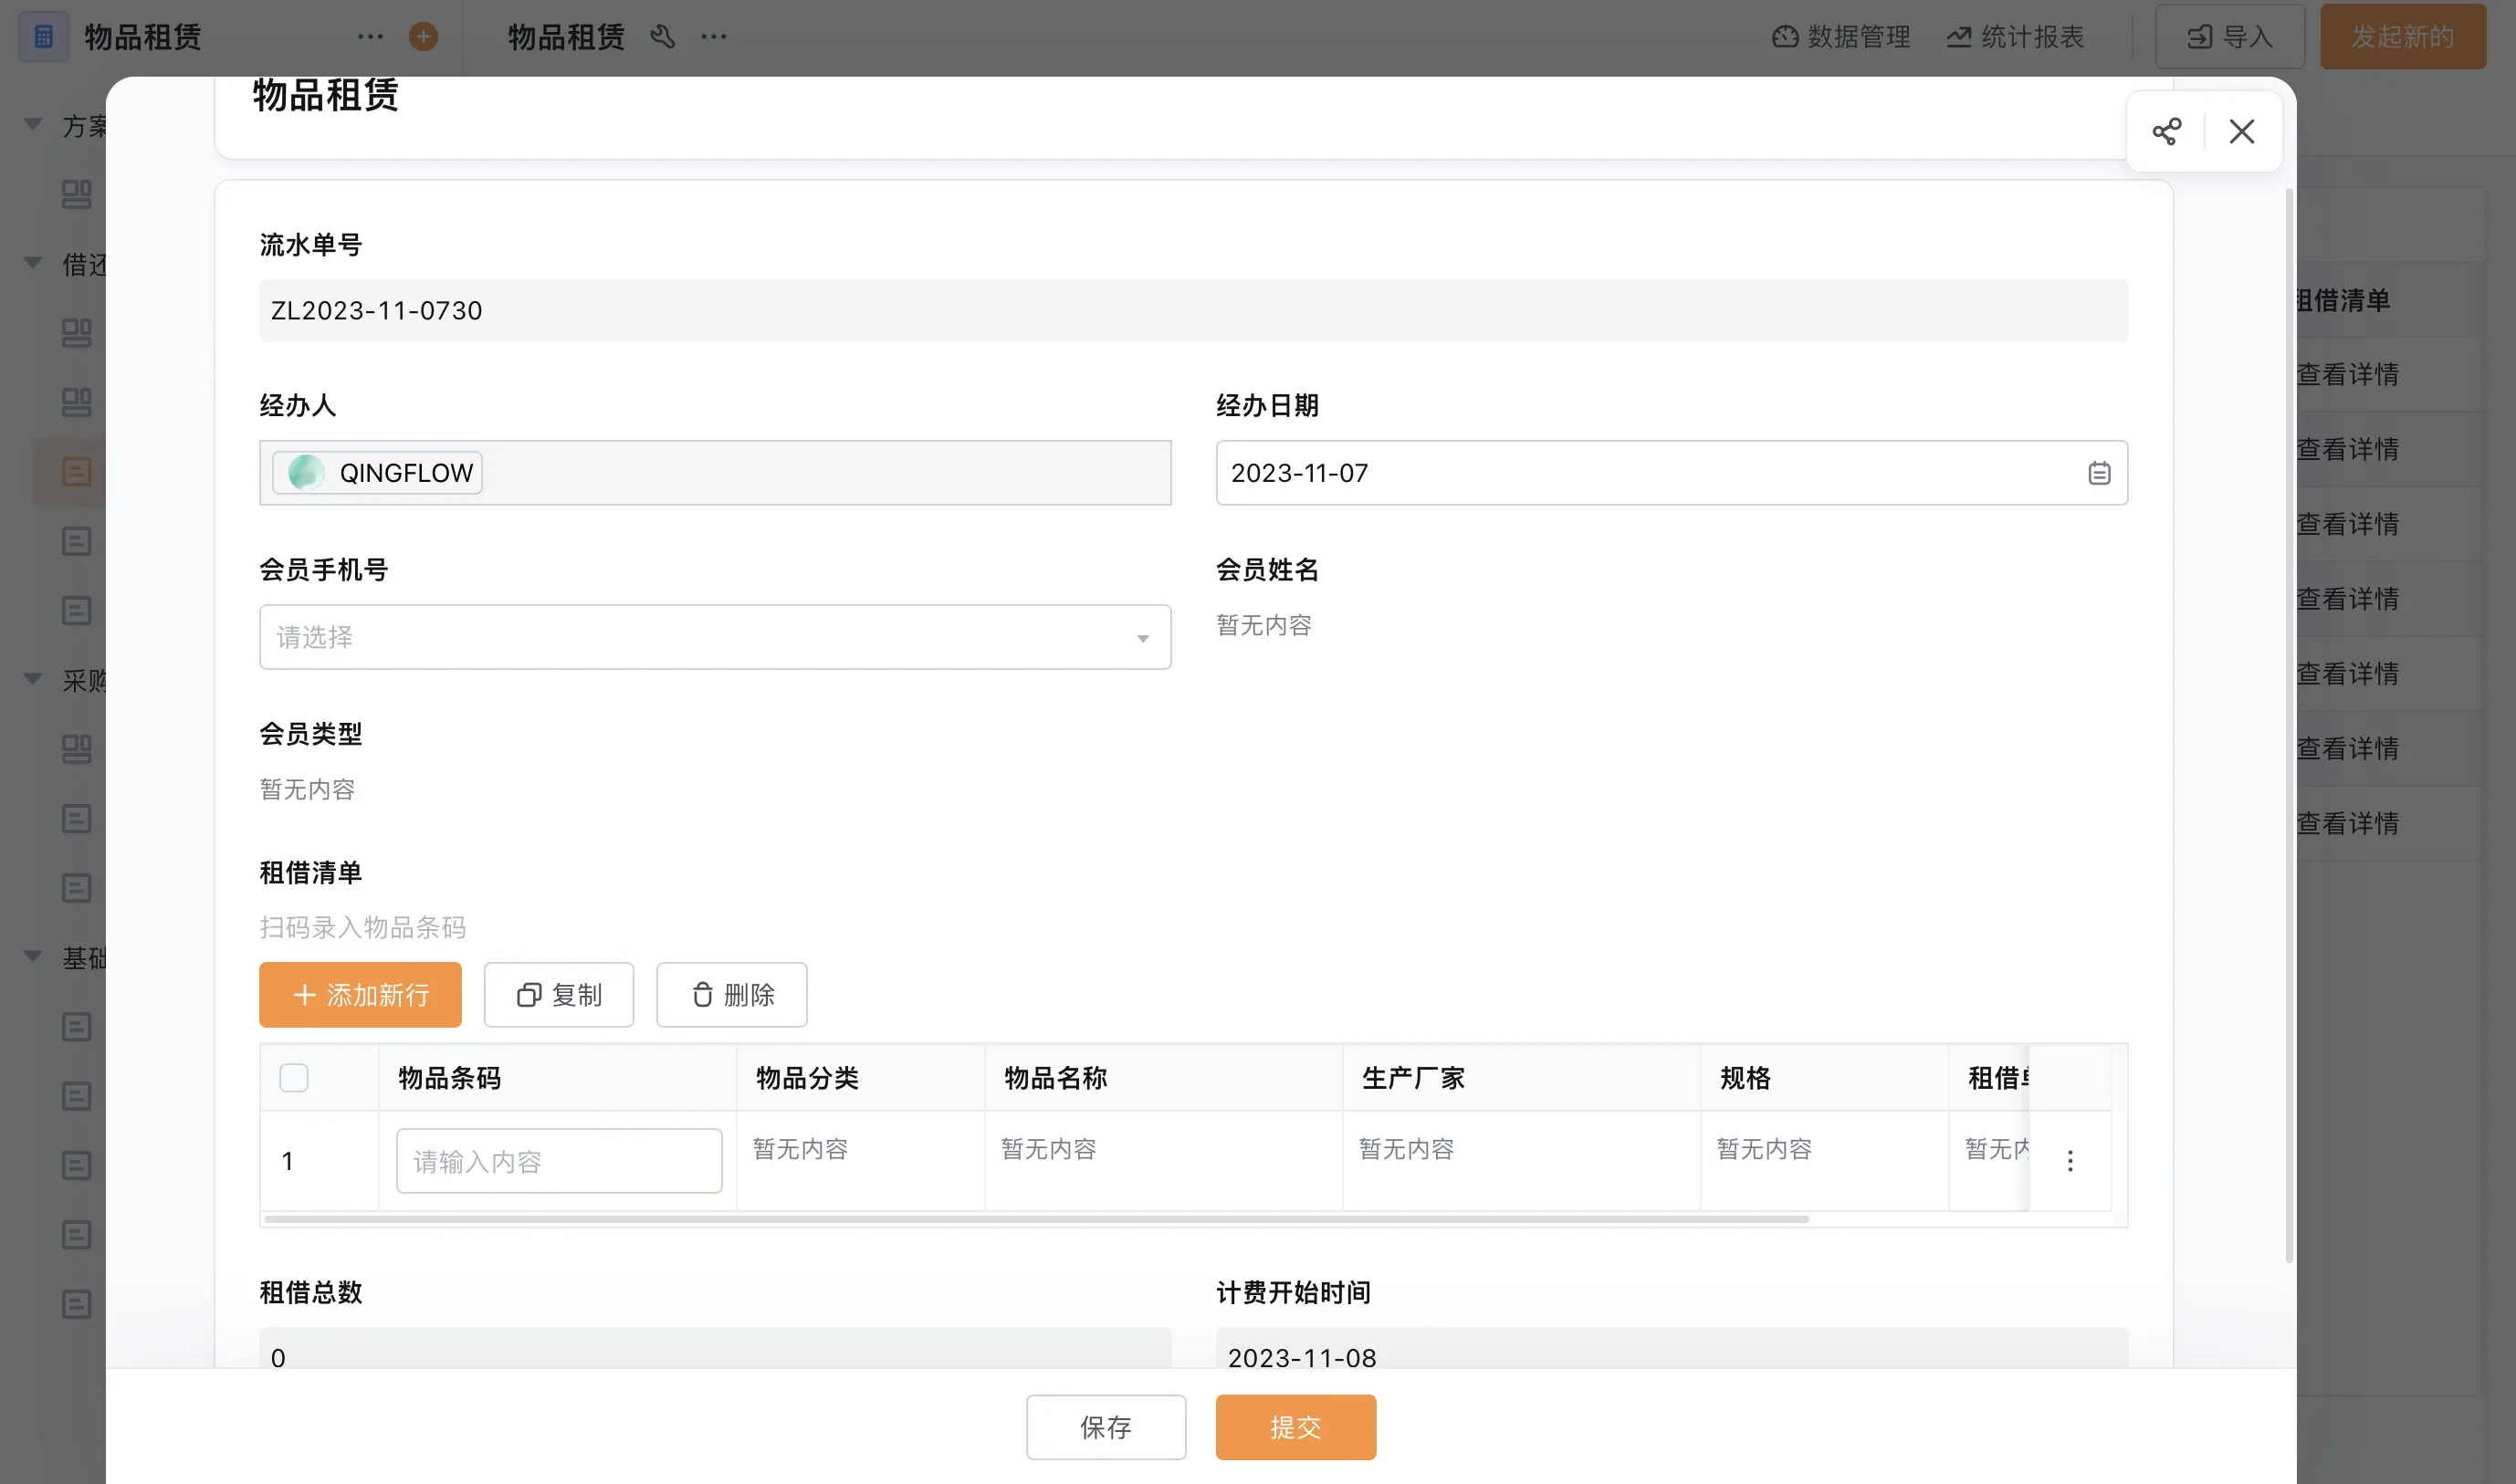
数据仓库管理体系包括哪些内容?如何构建高效的数据仓库管理体系?
在构建数据仓库管理体系时,需要同时兼顾技术架构、数据规范、治理流程与业务价值提升。一个高效的数据仓库管理体系,至少应包含总体架构规划、数据标准与模型体系、ETL与数据集成管理、元数据与主数据管理、数据质量管理、安全与权限控制、性能与容量管理、运维监控与成本管理、数据服务与产品化、组织与流程治理等核心内容。在实际落地中,应以业务场景为驱动,从小处切入,采用分层架构与统一数据标准,建立自动化的数据管道和质量监控机制,将数据仓库打造成支撑分析决策与运营优化的“企业级数据底座”。同时,灵活运用云原生数仓、湖仓一体与低代码工具(如在线配置的进销存、WMS模板)等手段,可以在保证稳定性的前提下显著提升数据仓库建设与管理效率。
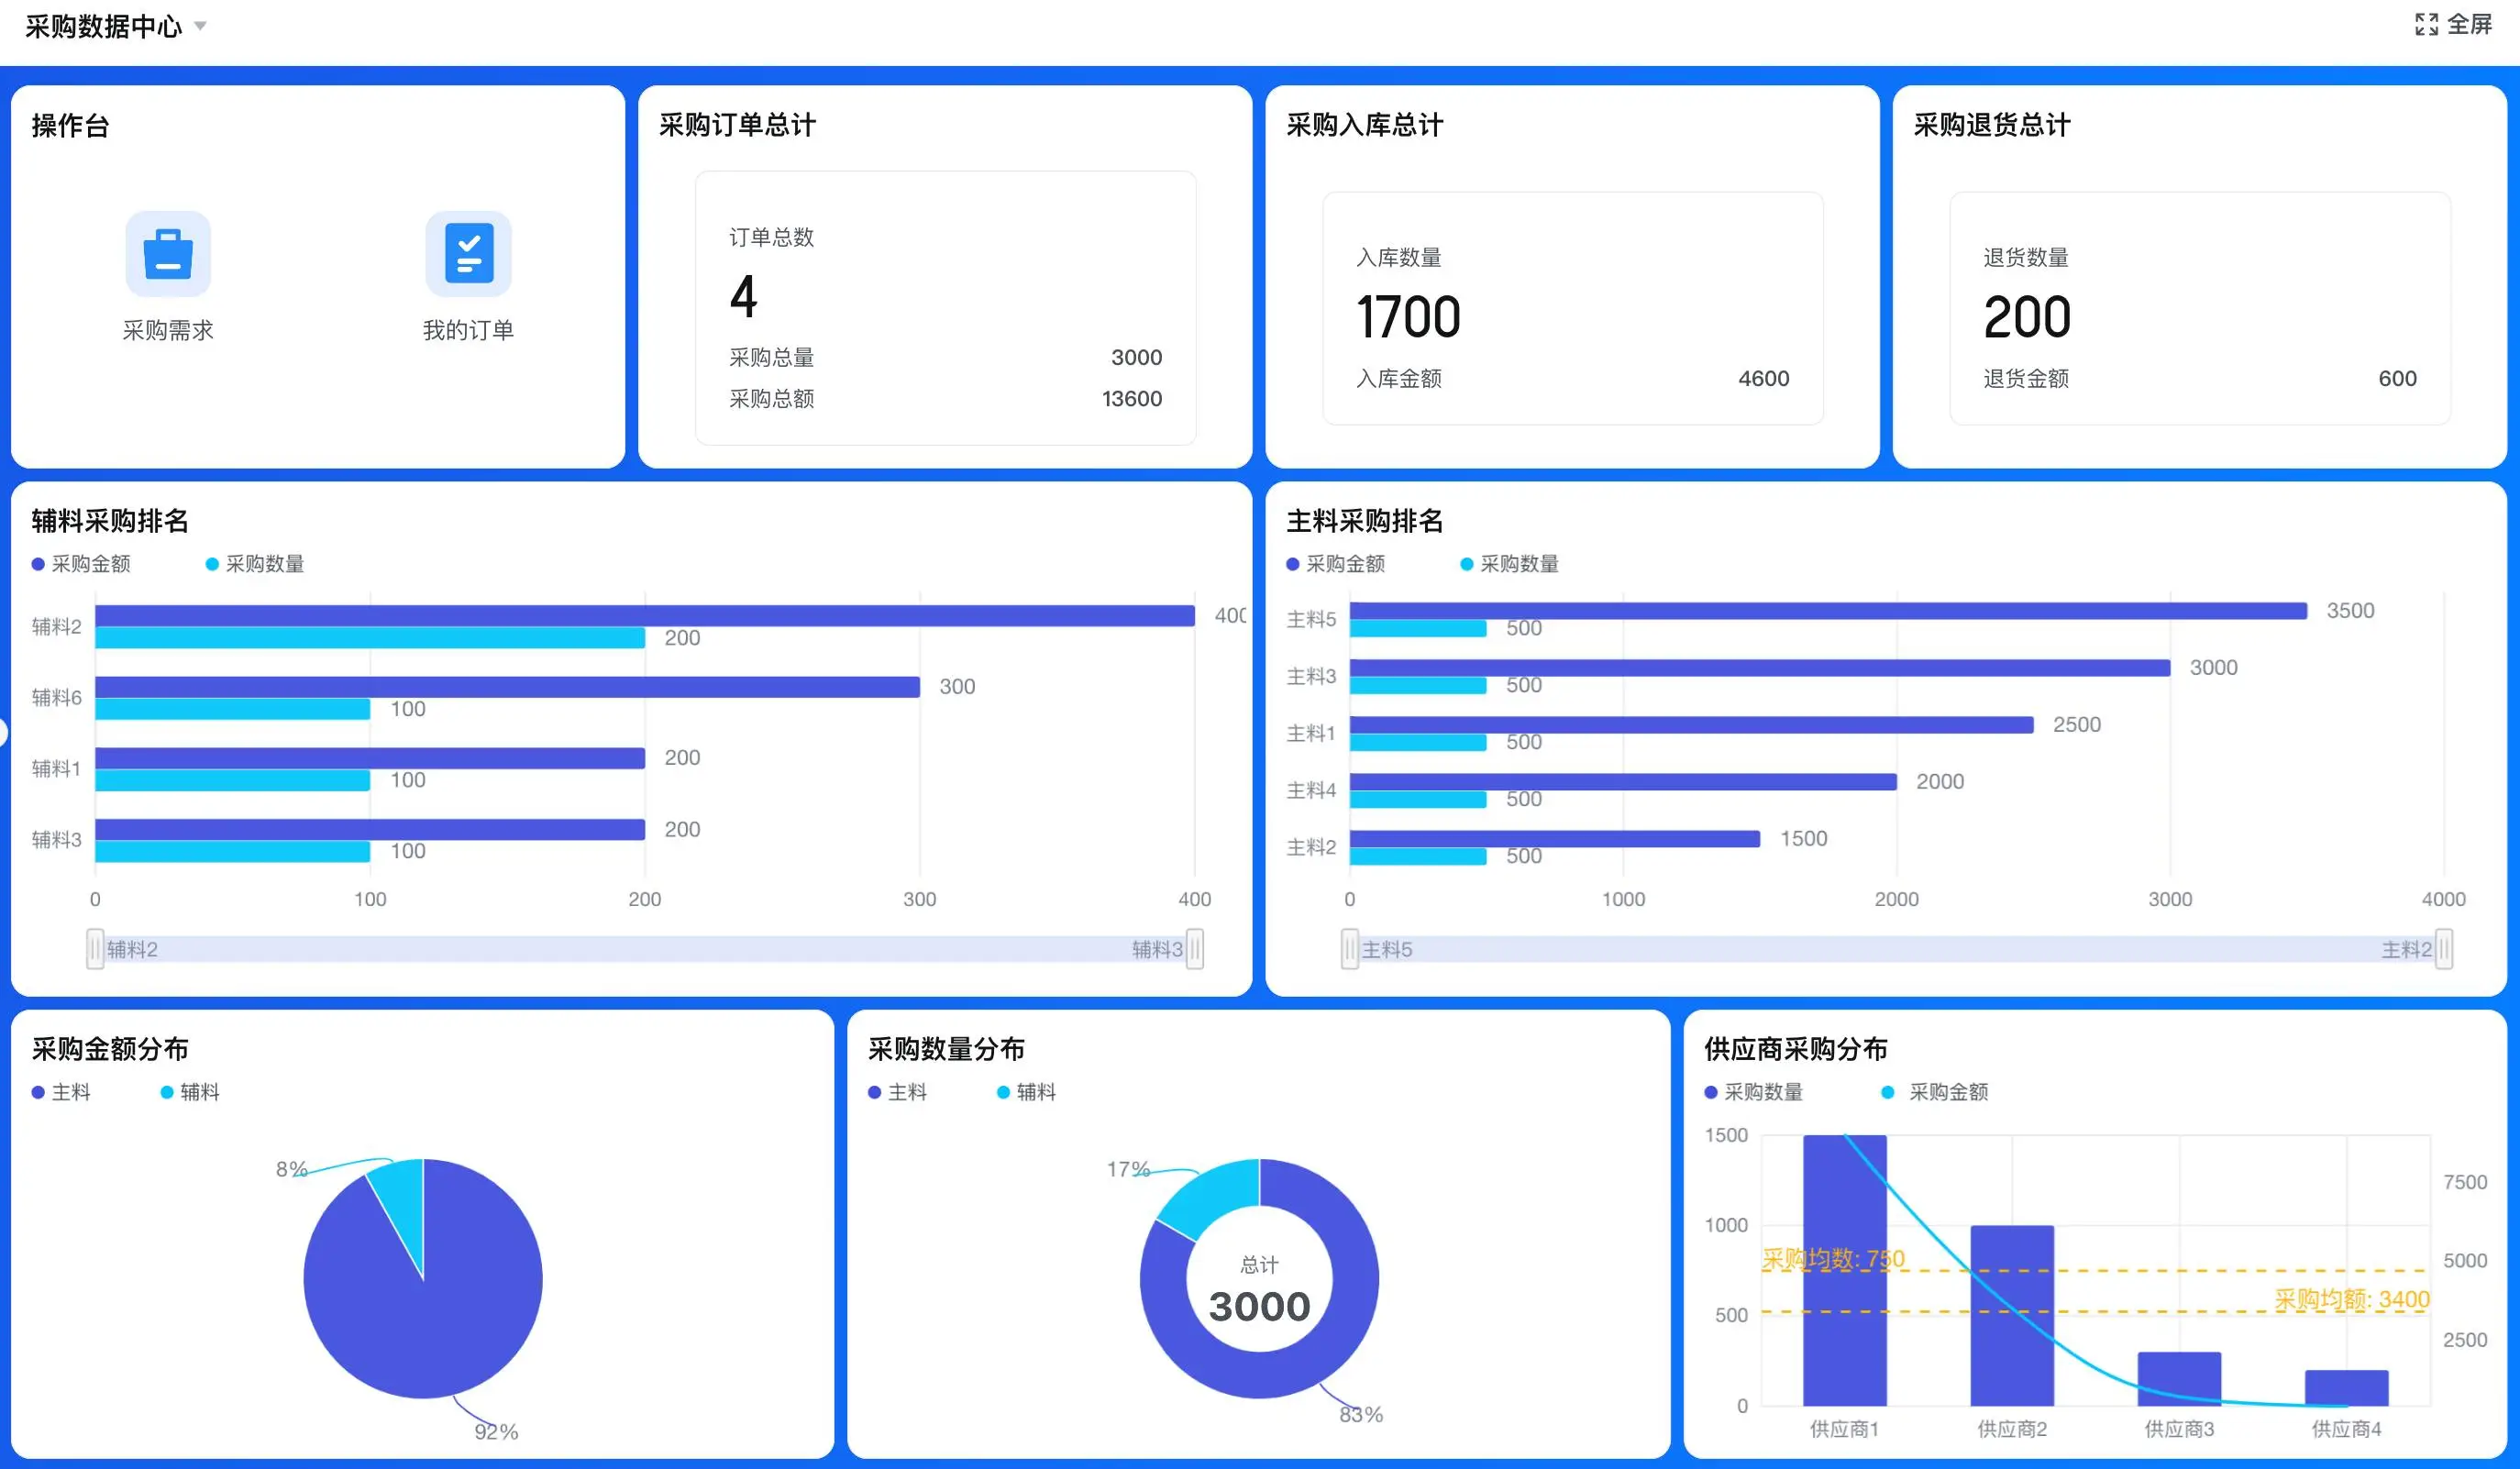
数据仓库管理工具指南,如何选择最适合你的方案?
数据仓库管理工具的选择关键在于:明确业务规模和复杂度,评估成本与团队技术栈,并围绕“性能、可扩展性、数据治理能力、生态兼容性和易用性”来综合衡量。不同类型的数据仓库管理工具(如云原生数据仓库、开源方案、传统本地方案以及湖仓一体平台)各有侧重,需要结合你的行业场景(电商、制造、SaaS、物流等)和现有 IT 基础设施逐项对比。通过先期的小规模 POC(概念验证)测试,再逐步扩展到全量业务,可有效降低风险。同时,可结合低代码平台、进销存系统与仓储管理模板实现从“数字化仓储”到“数仓治理”的一体化管理,帮助企业在可控成本下,持续打磨数据驱动能力。
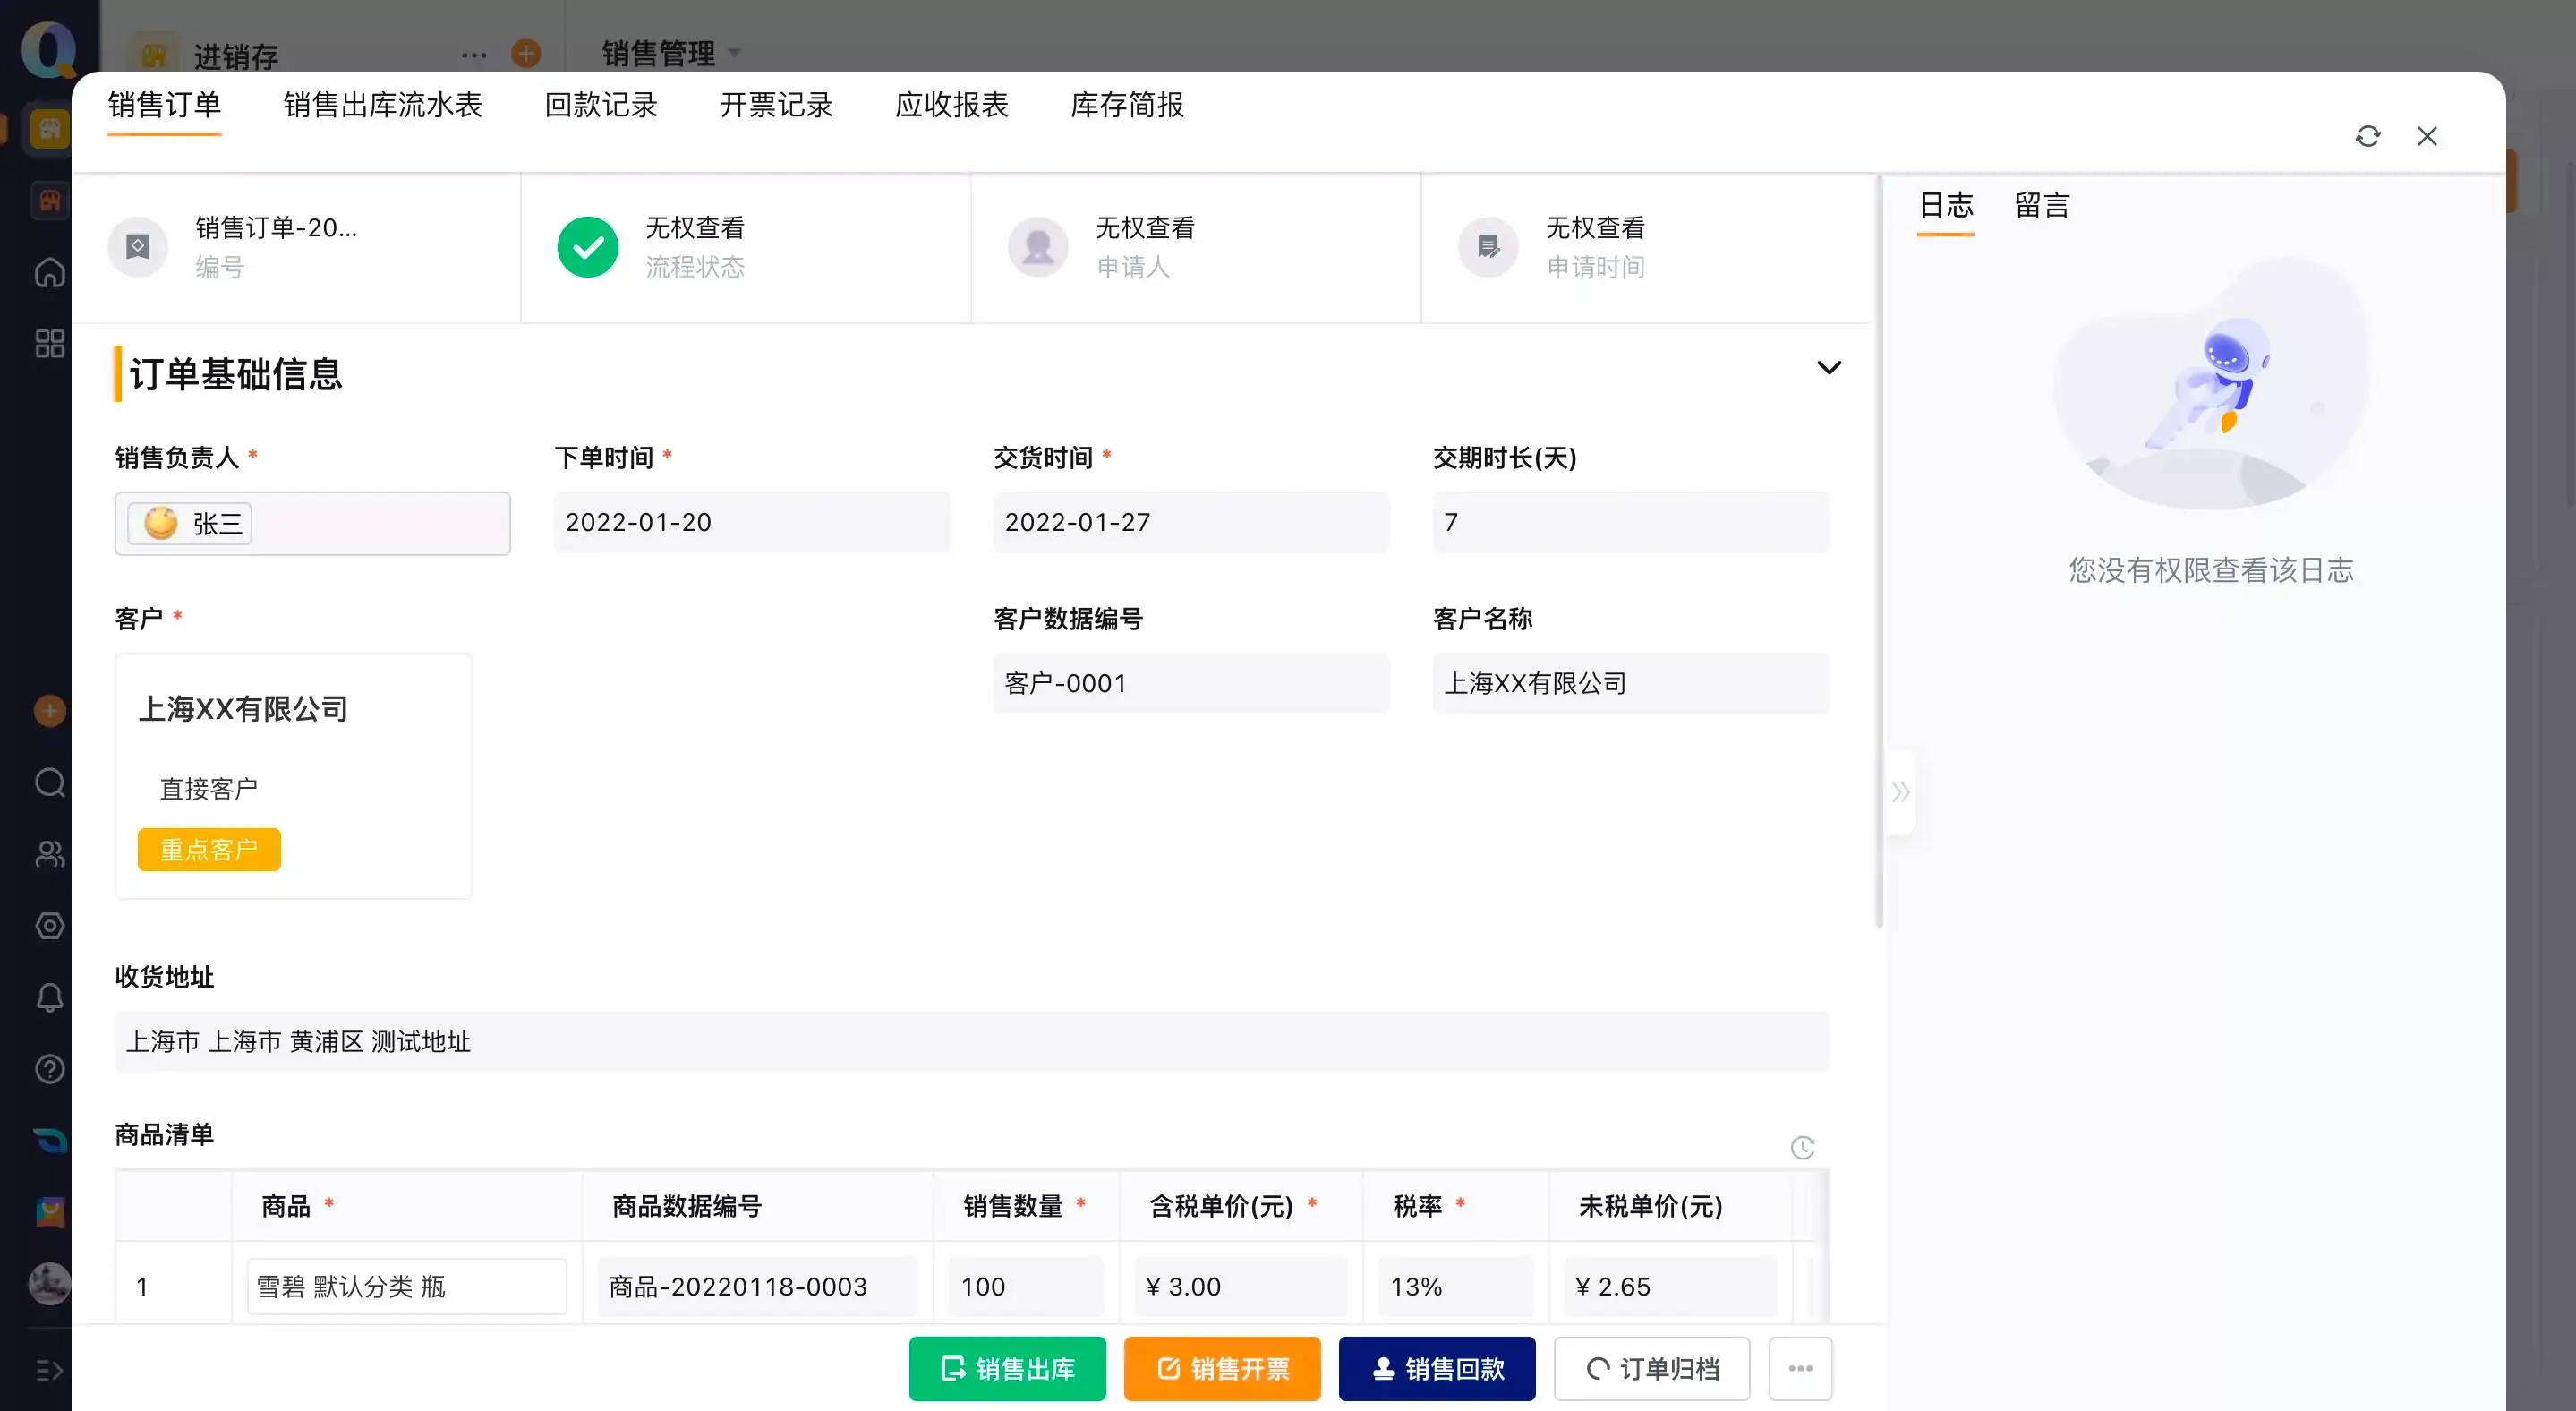
数据仓库分区管理详解,如何高效提升查询性能?
数据仓库分区管理是提升查询性能、降低存储成本与简化运维的关键手段。通过按照日期、地域、业务类型等维度对大表进行切分,配合合理的分区策略(如范围分区、哈希分区、复合分区),可以让查询引擎在扫描数据时只访问必要的分区,从而显著降低 IO 和 CPU 消耗。科学的分区设计可带来 310 倍的查询加速,同时提高装载效率,简化冷热数据分层与归档。要高效提升查询性能,需要综合考虑业务查询模式、数据规模、数据生命周期,选择合适的分区键与粒度,并配合自动分区维护、监控与调优机制,构建可持续演进的数据仓库分区管理体系。
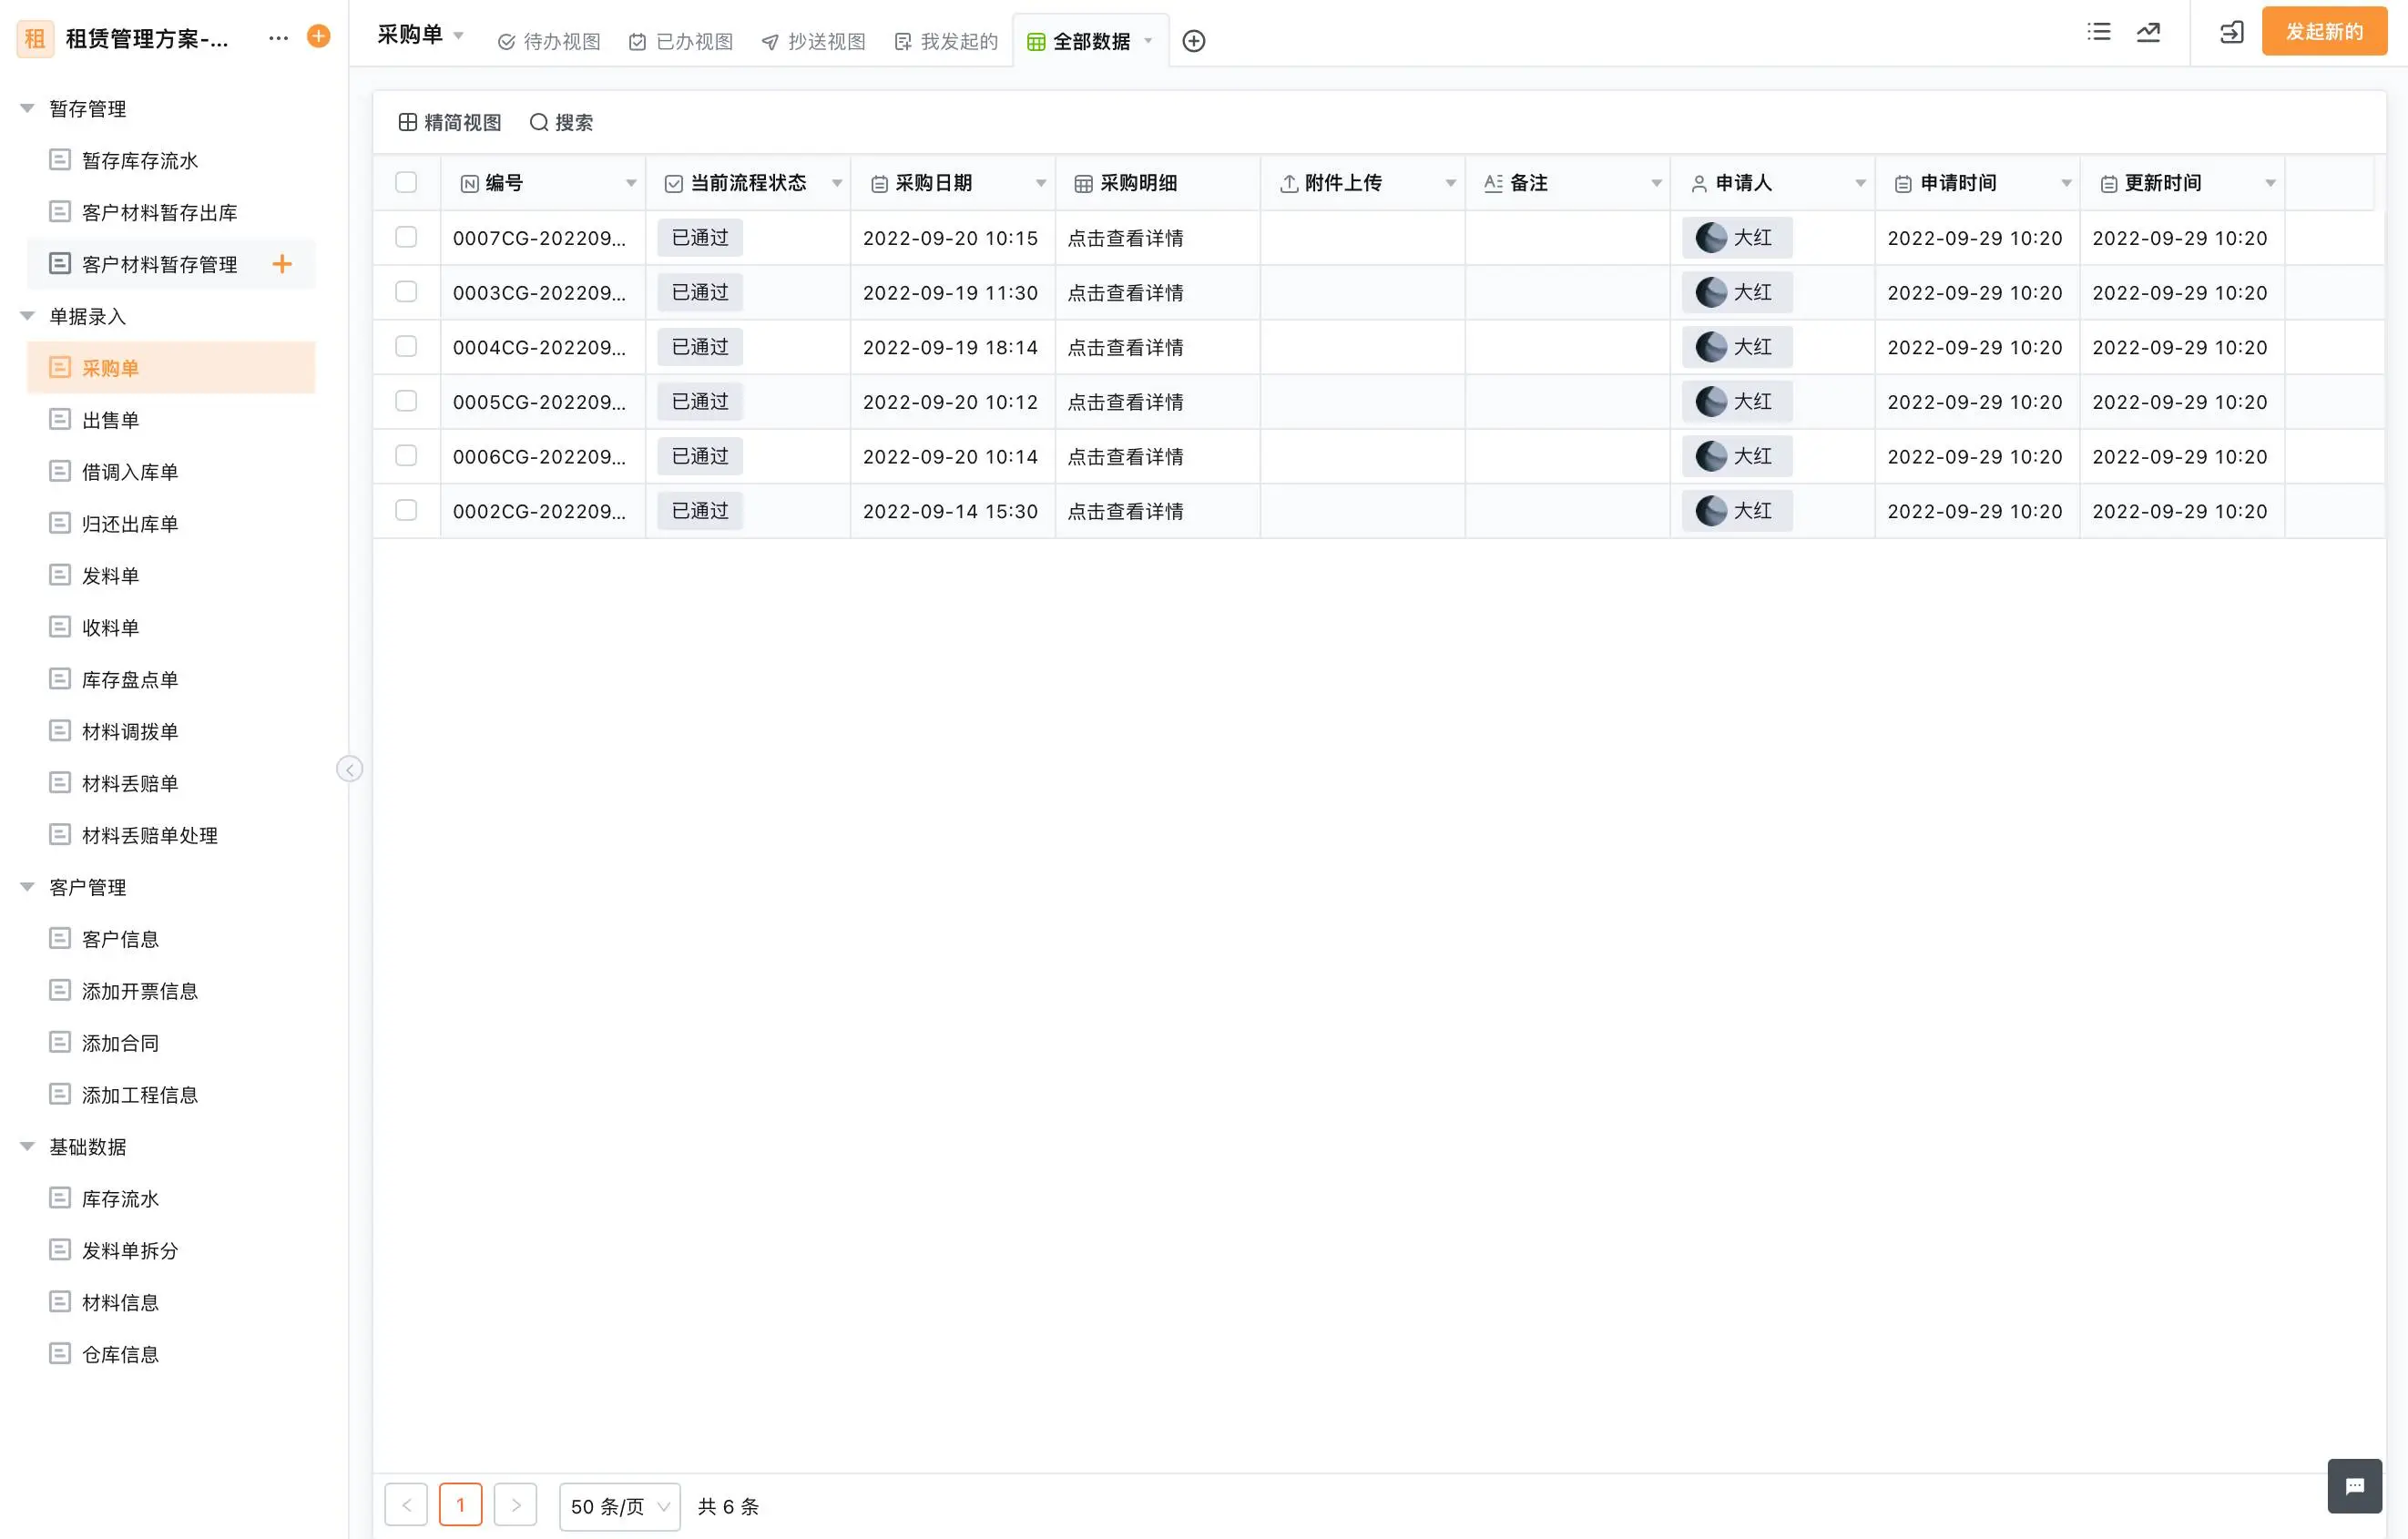
客户案例
看看轻流进销存管理系统的实际使用反馈
常见问题